8.部署超融合 Ceph 集群 Deploy Hyper-Converged Ceph Cluster
8.1.简介 Introduction
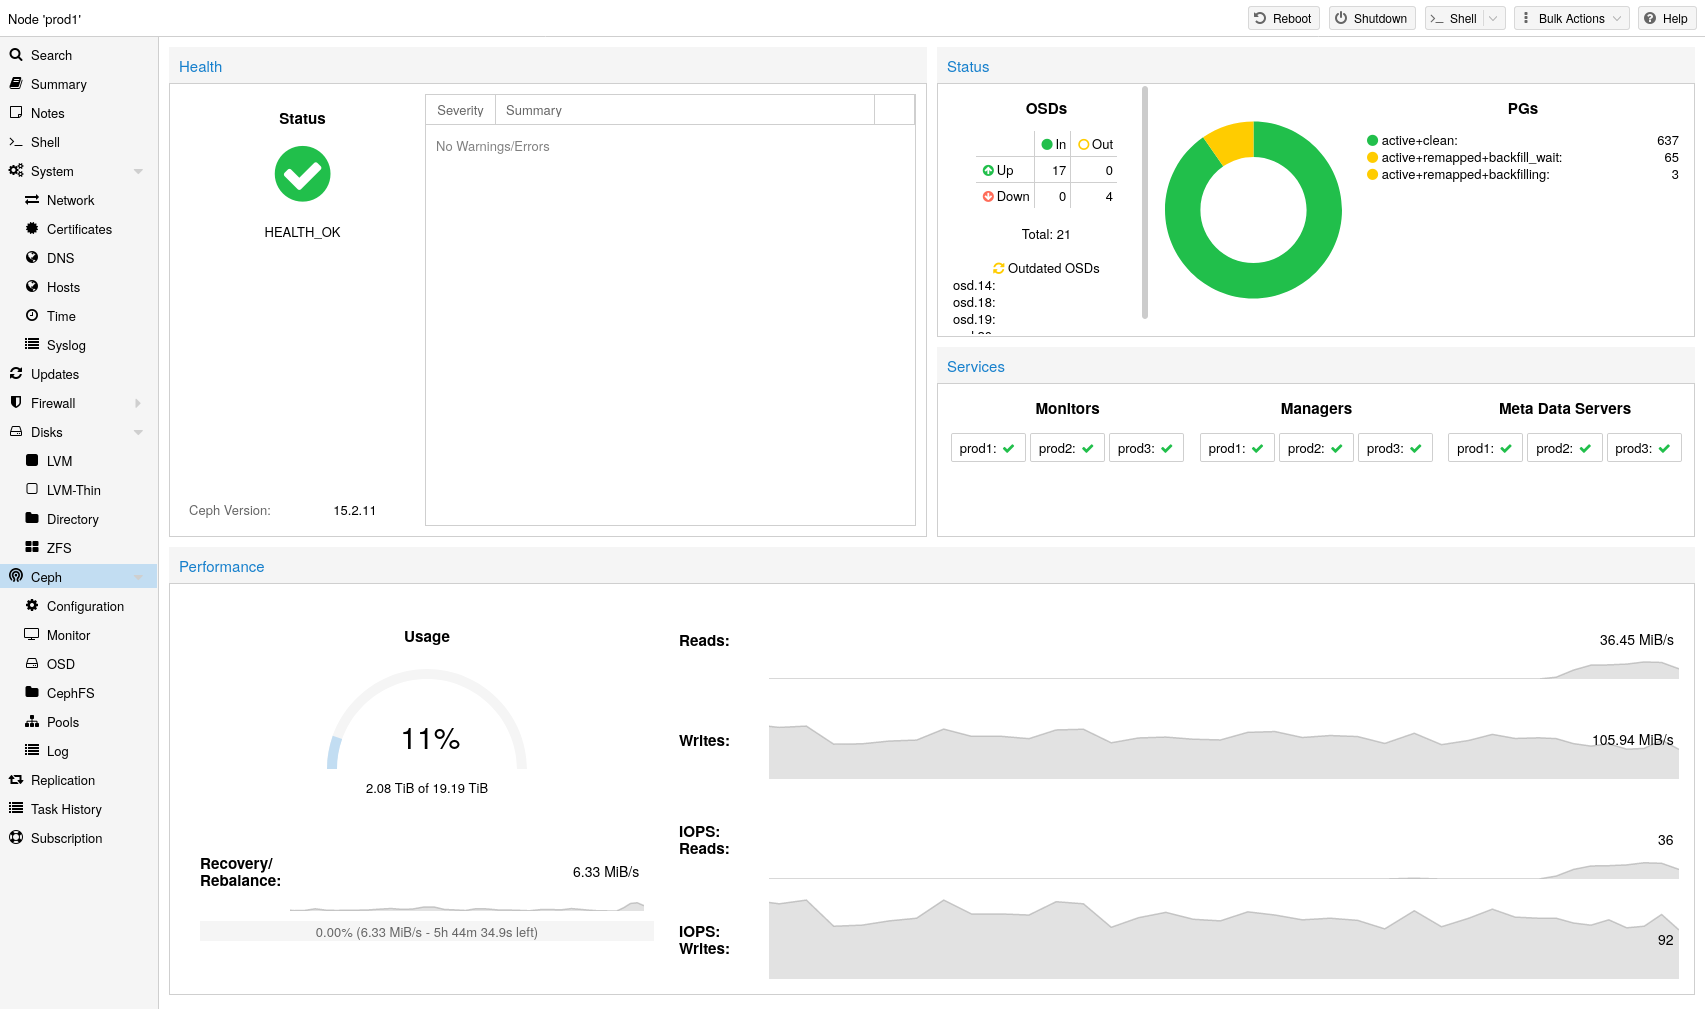
Proxmox VE 将计算与存储统一起来 , 即您可以在同一集群的物理节点上同时承担计算(运行 VM 与容器)和复制存储。传统把计算与存储分仓管理的模式被 超融合一体化设备 所取代 , 独立 SAN 与 NAS 连接不再必需。借助集成 Ceph 这一开源软件定义存储平台 , Proxmox VE 可直接在 hypervisor 节点上运行和管理 Ceph 存储。
Ceph 是分布式对象存储与文件系统 , 面向卓越的性能、可靠性与可扩展性。在 Proxmox VE 上使用 Ceph 的优势:
- CLI 与 GUI 便捷安装与管理
- 精简置备、快照、自愈
- 可扩展至 EB 级
- 同时提供块、文件、对象存储
- 可建立具有不同性能与冗余特征的存储池
- 数据复制 , 具备容错
- 运行于通用硬件 , 无需硬件 RAID 控制器
- 开源
对中小规模部署 , 可直接在 Proxmox VE 集群节点上安装 Ceph 服务器 , 以 RBD 或 CephFS 形式使用。现代硬件 CPU / 内存充沛 , 在同节点上同时跑存储服务与虚拟客户机完全可行。
为简化管理 , Proxmox VE 提供原生集成 , 既可通过 Web UI 也可通过 pveceph CLI 管理节点上的 Ceph 服务。
8.2.术语 Terminology
Ceph 由多个守护进程组成 , 作为 RBD 存储用途的包含:
- Ceph Monitor(
ceph-mon, MON) - Ceph Manager(
ceph-mgr, MGR) - Ceph Metadata Service(
ceph-mds, MDS) - Ceph Object Storage Daemon(
ceph-osd, OSD)
8.3.健康 Ceph 集群的建议 Recommendations for a Healthy Ceph Cluster
搭建超融合 Proxmox + Ceph 集群 , 至少需要 3 台(最好同构的)服务器。另请参考 Ceph 官网的硬件推荐。
以下建议仅为粗略指引 , 仍需结合您的实际需求调整 , 并持续测试、监控健康与性能。
CPU
Ceph 服务分两类:
- CPU 密集型(受益于高主频与多核): OSD、 CephFS 的 MDS。
- CPU 一般(不依赖多核): MON、 MGR。
经验法则 :每个 Ceph 服务至少分配 1 个 CPU 核 / 线程作为稳定运行所需的最低资源。例如节点上要跑 1 个 MON、 1 个 MGR、 6 个 OSD , 为稳定的基础性能应预留 8 个 CPU 核给 Ceph。 OSD 的 CPU 消耗主要取决于磁盘性能 —— 企业级 NVMe SSD 可持续提供 10 万 – 50 万 IOPS 且亚毫秒延迟 , 每个 OSD 可占用多个线程(高端 NVMe 上每 OSD 4–6 线程是常见)。
内存
超融合部署中尤其要精心规划并监控内存 : 除 VM / 容器预估占用外 , 还必须为 Ceph 保留足够内存以获得出色而稳定的性能。恢复、重平衡、回填等关键操作会让 Ceph 占用更多内存 , 因此日常运行不应把内存用满 , 应留出余量应对故障。
当前建议每个 OSD 配备至少 8 GiB 内存以获得良好性能;默认 OSD 守护进程需 4 GiB。
总内存占用主要由 OSD 数量决定;但在关键操作中 , 所有 Ceph 服务都可能需要额外内存。
网络
建议至少 10 Gbps 的专用 Ceph 网络。若没有 10+ Gbps 交换机 , 3 – 5 节点小集群也可考虑「全互联」网格拓扑。
恢复期间的流量会干扰同网段其他服务 , 尤其是对延迟敏感的 Proxmox VE corosync 栈 , 可能造成 quorum 丢失。将 Ceph 流量移至物理独立网络可避免此类干扰。
带宽估算应结合磁盘性能 :单块 HDD 跑不满 1 Gbps , 但节点上多块 HDD 的 OSD 汇总已能跑满 10 Gbps ; 单块 NVMe SSD 就能跑满 10 Gbps 甚至更多。高性能场景建议至少 25 Gbps, 甚至需要 40 Gbps / 100+ Gbps。若不确定 , 建议高性能配置使用三张物理独立网络:
- 一张超高带宽(25+ Gbps)用于 Ceph 集群(内部)流量
- 一张高带宽(10+ Gbps)用于 Ceph 公共流量(Ceph 服务 ↔ 客户端), 视需求还可承载客户机流量与在线迁移
- 一张中等带宽(1 Gbps)专供延迟敏感的 corosync 通信
磁盘
规划 Ceph 集群规模时要考虑 恢复时间。小集群恢复可能较慢 , 建议用 SSD 替代 HDD 以缩短恢复窗口、降低恢复过程中再次故障的风险。 SSD 提供更高 IOPS, 配合成本考虑 , 可用 基于类的存储池分离; 或给 OSD 挂接更快的磁盘作为 journal / DB / WAL 设备;一块更快磁盘服务多 OSD 时要平衡好数量 , 否则该快盘会成为瓶颈。
除磁盘类型外 , Ceph 在 每节点磁盘大小均匀、数量均匀 时表现最佳 : 每节点 4 × 500 GB 优于「1 × 1 TB + 3 × 250 GB」混搭。还要平衡 OSD 数量与单 OSD 容量 :容量越大密度越高 , 但单 OSD 故障时一次需要恢复的数据也越多。
避免 RAID
Ceph 自行处理对象冗余与并行写 , 使用 RAID 控制器通常并不提高性能或可用性;反之 , Ceph 设计上直接管理整盘 , RAID 控制器不适合 Ceph 负载 , 其写与缓存算法可能与 Ceph 冲突 , 有时还会降低性能。
避免 RAID 控制器 , 请改用 HBA(host bus adapter)。
8.4.Ceph 初始安装与配置 Initial Ceph Installation & Configuration
8.4.1.通过 Web 向导 Using the Web-based Wizard
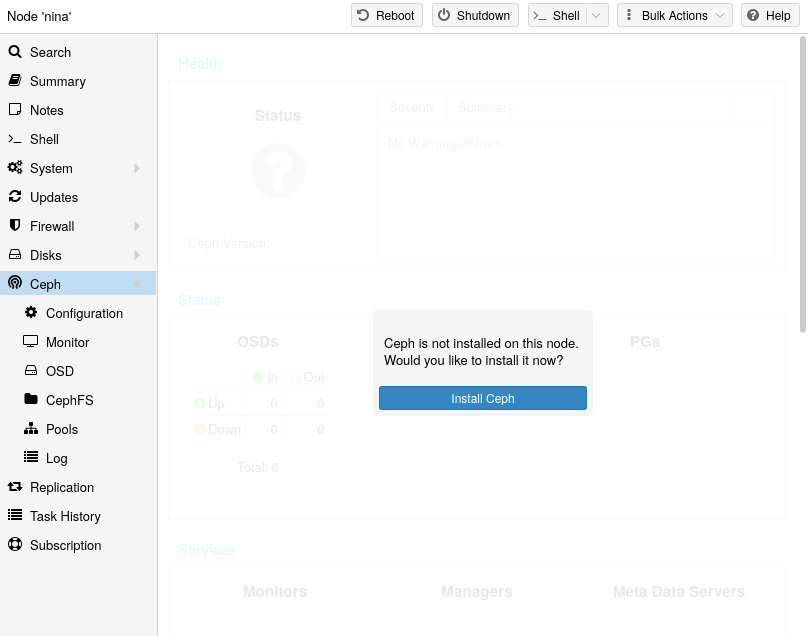
Proxmox VE 内置易用的 Ceph 安装向导。选中任一集群节点 , 在菜单树中进入 Ceph 版块 , 若尚未安装即有提示。向导分多个阶段 , 全部成功方可使用 Ceph。
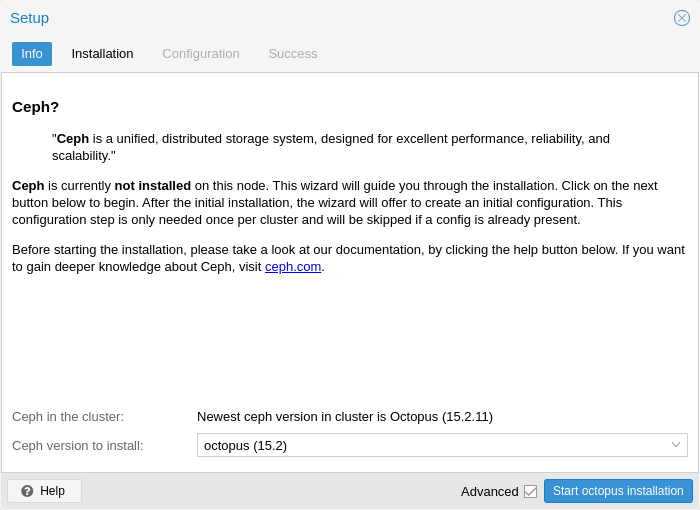
先选 Ceph 版本 —— 与其他节点保持一致;若为首个节点则选最新版。启动后向导会从 Proxmox VE 的 Ceph 仓库下载并安装所需软件包。
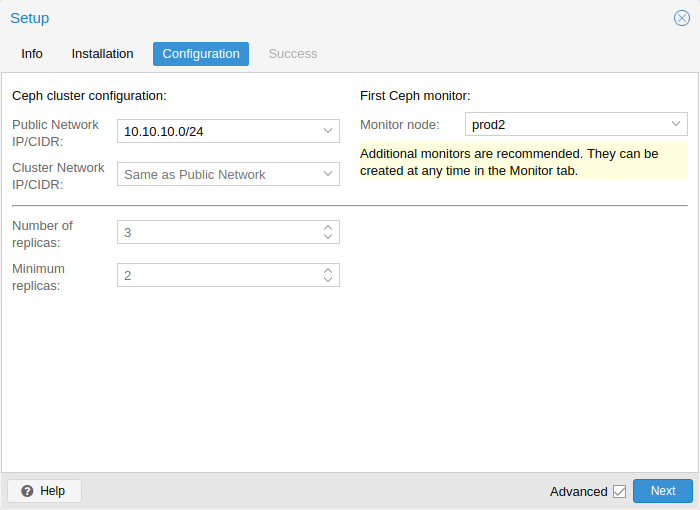
安装完成后需要创建配置 —— 每个集群只做一次 , 配置通过 pmxcfs 自动分发。包括:
- Public Network(必填): 面向公共存储流量(如 VM 使用的 RBD、 CephFS)与 Ceph 各服务间通信。强烈建议将其与 corosync 及客户机前端网络分开。
- Cluster Network(可选): 分离 OSD 复制与心跳流量。物理独立网络可明显提升 Ceph 性能 , 也减轻公共网与客户机流量的压力;之后也可再迁移到其他物理网络。
- Number of replicas(进阶): 对象副本数。
- Minimum replicas(进阶): 确认 I/O 完成所需最小副本数。
- 还需选择首个 Monitor 节点(必填)。
随后在成功页可见后续指引。系统已可开始使用 Ceph , 您需要创建额外的 Monitor、 OSD 以及至少一个 Pool。本章余下内容将引导您把 Proxmox VE + Ceph 的能力用到极致 , 包括 CephFS。
8.4.2.通过 CLI 安装 Ceph 包 CLI Installation of Ceph Packages
作为 Web 向导的替代 , 可在每个节点执行:
pveceph install
此命令会在 /etc/apt/sources.list.d/ceph.sources 设置 apt 仓库 , 并安装所需软件。
8.4.3.通过 CLI 进行初始配置 Initial Ceph configuration via CLI
推荐使用 Web 向导;或在一台节点上运行:
pveceph init --network 10.10.10.0/24
此命令在 /etc/pve/ceph.conf 生成带专用网络的初始配置 , 文件由 pmxcfs 自动分发到所有节点;同时创建指向该文件的符号链接 /etc/ceph/ceph.conf, 因此可直接运行 Ceph 命令而无需指定配置文件。
8.5.Ceph Monitor Ceph Monitor
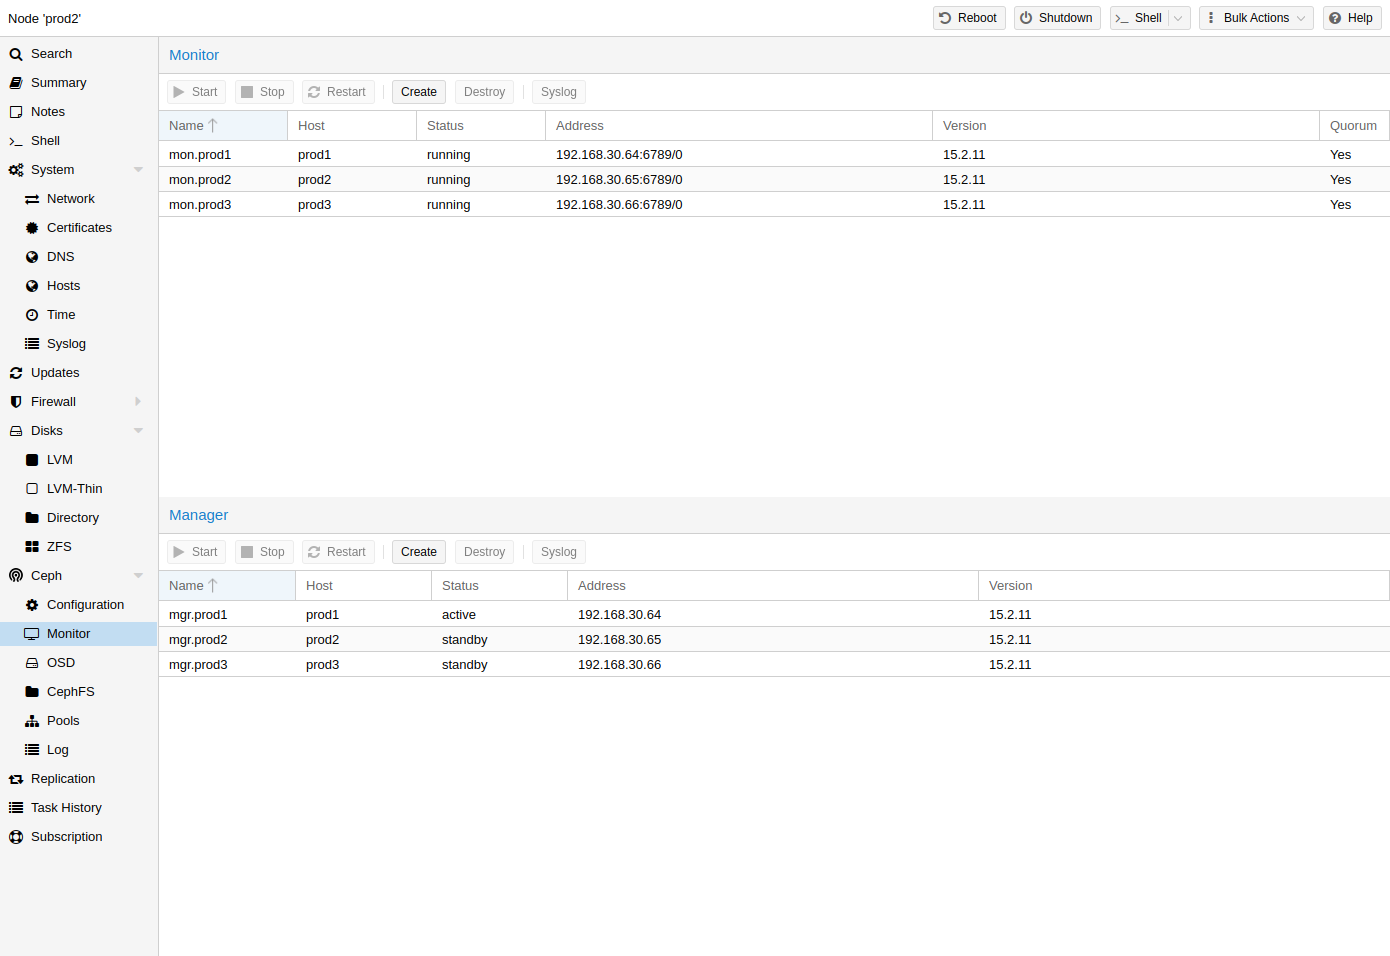
Ceph Monitor(MON)维护集群映射的主副本。为高可用至少需要 3 个 Monitor —— 使用向导后已有 1 个。中小规模集群无需超过 3 个 , 只有超大集群才会需要更多。
8.5.1.创建 Monitor Create Monitors
在每台拟作为 Monitor 的节点上 , 通过 GUI Ceph → Monitor 或 CLI:
pveceph mon create
8.5.2.销毁 Monitor Destroy Monitors
GUI 中选节点 → Ceph → Monitor → 选中 MON → Destroy。 CLI 中先登录运行 MON 的节点 , 再执行:
pveceph mon destroy
至少需要 3 个 Monitor 以维持 quorum。
8.6.Ceph Manager Ceph Manager
Manager 守护进程与 Monitor 一同运行 , 为集群监控提供接口。自 Ceph Luminous 起至少需要一个 ceph-mgr。
8.6.1.创建 Manager Create Manager
可安装多个 Manager, 但任意时刻仅一个处于 active:
pveceph mgr create
建议在 Monitor 节点上部署 Manager。为高可用部署多个 Manager。
8.6.2.销毁 Manager Destroy Manager
GUI 中 Ceph → Monitor 选中 Manager → Destroy。 CLI:
pveceph mgr destroy
Manager 并非硬依赖 , 但对 Ceph 集群至关重要 —— 承担 PG autoscaling、设备健康监控、遥测等功能。
8.7.Ceph OSD Ceph OSDs
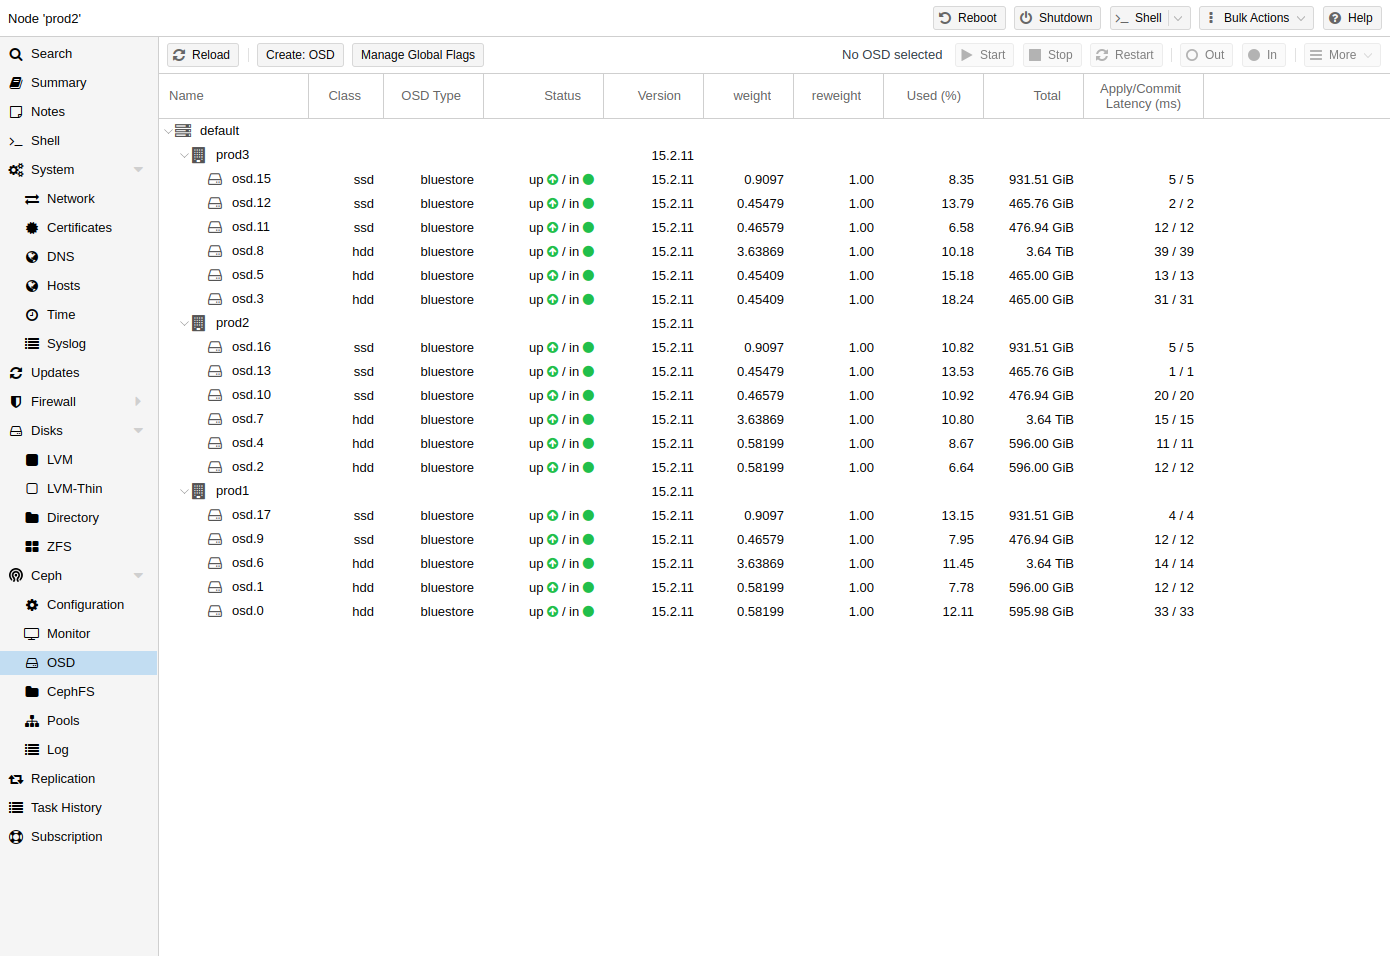
Ceph Object Storage Daemon 通过网络为 Ceph 存储对象 , 建议 每块物理盘一个 OSD。
8.7.1.创建 OSD Create OSDs
可通过 Web UI 或 pveceph:
pveceph osd create /dev/sd[X]
建议至少 3 节点、 12 个 OSD, 且均匀分布。
若磁盘曾被使用(例如 ZFS 或旧 OSD), 先 zap 去除分区表、引导扇区与残留:
ceph-volume lvm zap /dev/sd[X] --destroy
上述命令会销毁磁盘上全部数据!
Ceph BlueStore
自 Ceph Kraken 起引入的新 OSD 存储类型 , 自 Luminous 起为默认:
pveceph osd create /dev/sd[X]
block.db 与 block.wal
为 OSD 使用独立 DB / WAL 设备可用 -db_dev、 -wal_dev; WAL 未单独指定时与 DB 放在一起:
pveceph osd create /dev/sd[X] -db_dev /dev/sd[Y] -wal_dev /dev/sd[Z]
大小可用 -db_size / -wal_size 指定;若未指定 , 按以下优先级选取:
bluestore_block_{db,wal}_size— Ceph 配置中 :数据库osd段 → 数据库global段 → 文件osd段 → 文件global段- OSD 大小的 10%(DB)/ 1%(WAL)
DB 保存 BlueStore 内部元数据 , WAL 是 BlueStore 的内部日志 / 预写日志。建议使用高速 SSD 或 NVRAM 以获得更好性能。
Ceph Filestore
Luminous 之前的默认类型 ; 自 Nautilus 起 Proxmox VE 的 pveceph 不再创建 filestore OSD。如仍需 , 直接用 ceph-volume:
ceph-volume lvm create --filestore --data /dev/sd[X] --journal /dev/sd[Y]
8.7.2.销毁 OSD Destroy OSDs
若 OSD 或其磁盘出现问题 , 先尝试排查再决定是否替换。在节点上进入 Ceph → OSD , 或使用 CLI:
- 确保集群有足够空间承受该 OSD 的移除 : 在 OSD 面板上 , 若待销毁 OSD 仍 up 且 in(
AVAIL非零), 所有 OSD 的 Used (%) 应明显低于默认nearfull_ratio=85%, 以降低重平衡期间 OSD 写满阻塞 I/O 的风险。 CLI 查看:ceph osd df tree
- 若 OSD 尚未 out , 选中并点 Out(等同于 CLI
ceph osd out <id>), 开始重平衡。 - 尽可能等 Ceph 重平衡完成(该 OSD 的 PG 归零)。
- 点 Stop。若现在停止不安全会弹警告 , 请点 Cancel 稍后再试。 CLI:
ceph osd ok-to-stop <id>
pveceph stop --service osd.<id>
- 最后 More → Destroy, 勾选 cleanup 可清除分区表等结构 , 磁盘能直接被 Proxmox VE 复用 , 再点 Remove。 CLI:
pveceph osd destroy <id> [--cleanup]
8.8.Ceph 配置 Ceph Configuration

Ceph 守护进程与客户端从多处来源读取配置。 Proxmox VE 使用最简的 ceph.conf 保存引导设置 , 大部分配置保存在 MON 服务维护的中心配置数据库中。持久化修改配置值应使用:
| 命令 | 作用 |
|---|---|
ceph config dump | 显示所有配置选项 |
ceph config get <entity> | 显示实体的配置选项 |
ceph config set <entity> <key> <value> | 为一个或多个实体设置配置 |
ceph config rm <entity> <key> | 清除一个或多个实体的配置 |
示例 :提高所有 OSD 的 osd_memory_target:
ceph config set osd osd_memory_target 8G
若本地配置文件存在同名选项 , 其优先级低于 MON 中心数据库 , MON DB 中的同名值会被忽略。
8.9.Ceph Pools Ceph Pools
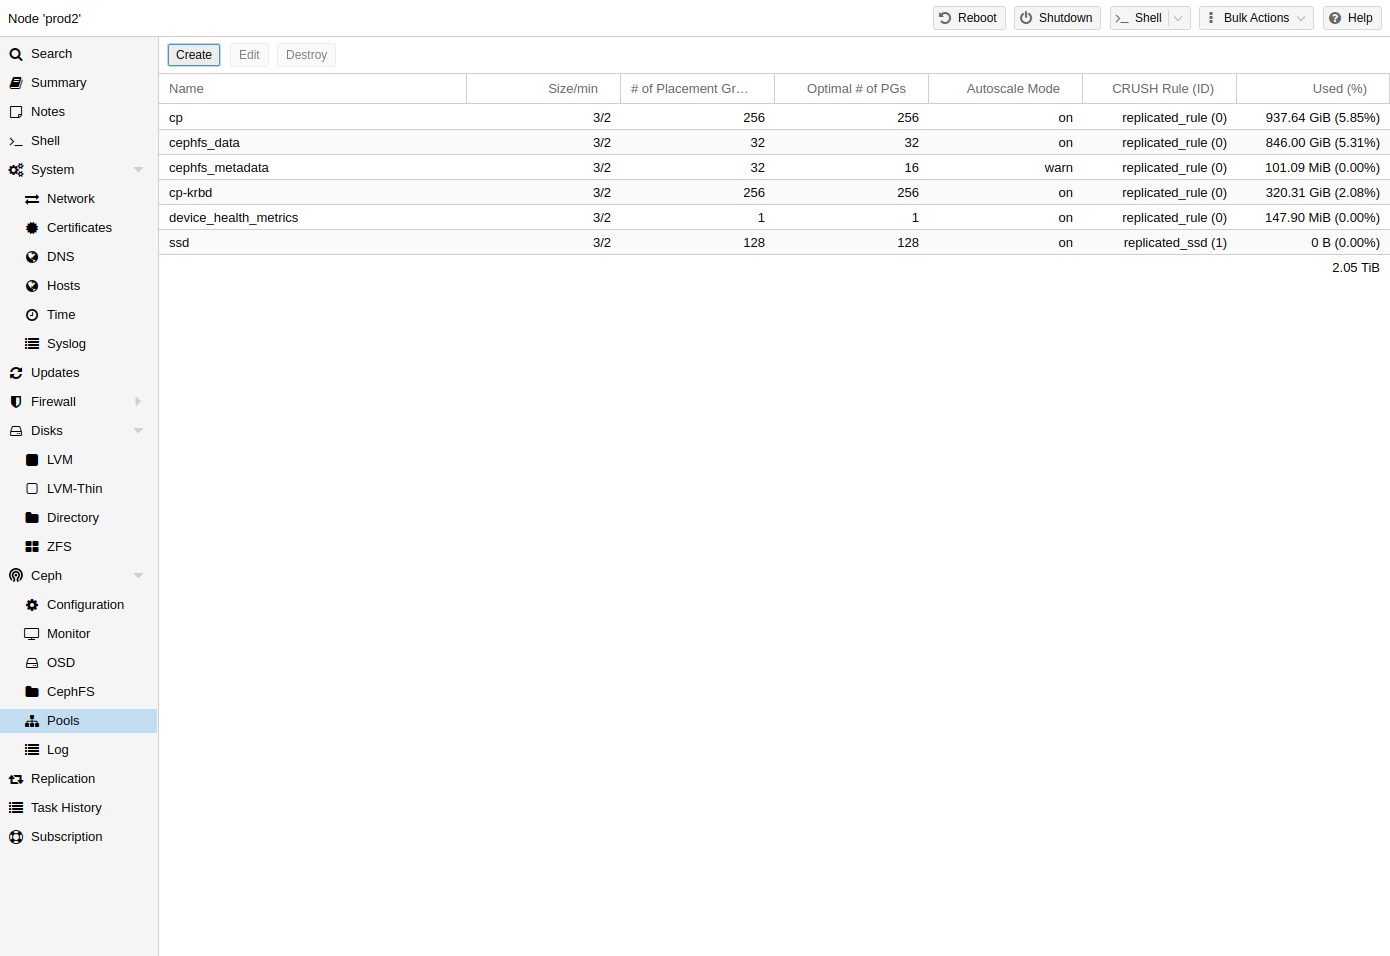
Pool 是存放对象的逻辑分组 , 由一系列 放置组(PG, pg_num) 组成。
8.9.1.创建与编辑 Pool Create and Edit Pools
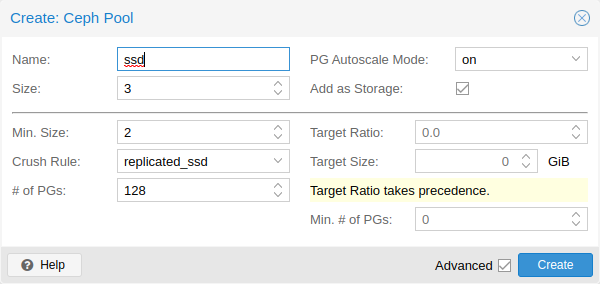
可通过 CLI 或任一节点 Web UI Ceph → Pools 创建与编辑。未指定时默认 128 PG、 size=3、 min_size=2, 确保任一 OSD 故障不丢数据。
不要 将 min_size 设为 1。副本池 min_size=1 意味着仅剩一份副本时仍允许 I/O, 可能导致数据丢失、 PG 不完整或对象丢失。
建议启用 PG-Autoscaler, 或按公式计算 PG 数(网上有 PG 计算器)。自 Nautilus 起支持在建池后修改 PG 数。 PG autoscaler 可在后台自动缩放 PG 数量;设置 Target Size 或 Target Ratio 能帮助它做出更好决策。
CLI 建池示例:
pveceph pool create <pool-name> --add_storages
若希望同时为池自动定义存储 , Web UI 中保留 「Add as Storage」复选框 , 或在 CLI 使用 --add_storages。
Pool 选项
- Name
- 池名 , 必须唯一 , 创建后不可更改。
- Size
- 每对象副本数 , 默认
3。 - PG Autoscale Mode
- 自动 PG 缩放模式 , 默认
warn(PG 数不佳时发告警)。 - Add as Storage
- 用新池创建 VM / 容器存储 , 默认 true(仅创建时可见)。
- Min. Size(进阶)
- 每对象最小副本数 , 默认
2; PG 副本少于此数时池拒绝 I/O。 - CRUSH Rule(进阶)
- 对象放置规则 , 详见 §8.10。
- # of PGs(进阶)
- 池初始 PG 数 , 默认 128。
- Target Ratio
- 池中预期数据占比;相对于其他池的比值 , 同时设置时优先于 Target Size。
- Target Size
- 池中预期数据量 , 供 autoscaler 估算最佳 PG。
- Min. # of PGs
- PG 数下限 , 调整自动缩放下界;低于此值 autoscaler 不再合并。
8.9.2.纠删码池 Erasure Coded Pools
纠删码(EC)是一种「前向纠错」, 可从一定量数据丢失中恢复。与副本池相比 EC 池可用空间更多 , 代价是性能较低。副本池存多个副本(size), EC 池则把数据切成 k 块数据块与 m 块编码(校验)块 , 缺失数据时由编码块重建。 m 决定可容忍的 OSD 丢失数 , 总对象数为 k + m。
创建 EC 池
通过 pveceph 创建 , 规划时应与副本池区分对待。 EC 池默认 min_size 视 m 而定 :m=1 时 min_size=k; m>1 时 min_size=k+1; Ceph 文档建议保守地取 k+2。可用 OSD 少于 min_size 时 , 池 I/O 会被阻塞。
规划 EC 池时务必关注 min_size —— 它决定至少要多少可用 OSD, 否则 I/O 被阻塞。
例如 k=2, m=1 → size=3, min_size=2 , 可容忍 1 个 OSD 故障;k=2, m=2 → size=4, min_size=3 , 可容忍 1 个 OSD 故障。创建:
pveceph pool create <pool-name> --erasure-coding k=2,m=1
可选参数 : failure-domain 与 device-class。要修改 EC profile , 需用新 profile 建新池。该命令会同时创建一个副本池用于 RBD omap 等元数据 , 产生 <pool>-data 与 <pool>-metadata 两个池 , 并默认创建匹配的存储配置(--add_storages 0 可禁用)。 手动配置存储时必须设置 data-pool, 否则 EC 池不会真正用来存放数据对象。
可选参数 --size、 --min_size、 --crush_rule 用于 副本元数据池 , 不用于 EC 数据池。 EC 数据池的 min_size 可事后修改 , 而 size 与 crush_rule 不可 修改。
若需进一步定制 EC profile, 请用 Ceph 工具直接创建后以 profile 参数指定:
pveceph pool create <pool-name> --erasure-coding profile=<profile-name>
将 EC 池作为存储加入
与加入 RBD 池方式相同 , 只是多一个 data-pool:
pvesm add rbd <storage-name> --pool <replicated-pool> --data-pool <ec-pool>
对于非本地管理的外部 Ceph 集群 , 别忘了补充 keyring 与 monhost 选项。
8.9.3.销毁 Pool Destroy Pools
GUI 中 Ceph → Pools 选中 → Destroy(需键入池名确认)。 CLI:
pveceph pool destroy <name>
加 -remove_storages 可一并移除关联存储。
删除在后台进行 , 可能耗时较长;期间集群数据使用量会逐步下降。
8.9.4.PG Autoscaler PG Autoscaler
autoscaler 让集群根据每池(预期)数据量自动选取合适的 pg_num, 自 Nautilus 起可用。可能需要先启用模块:
ceph mgr module enable pg_autoscaler
按池配置 , 三种模式:
warn- 建议
pg_num与当前值差距过大时发健康告警。 on- 自动调整
pg_num, 无需人工介入。 off- 既不自动调整 , PG 数不佳也不告警。
可用 target_size、 target_size_ratio、 pg_num_min 调整缩放因子。
autoscaler 默认在 PG 数偏差达到 3 倍时才调整 —— 一次变更会造成数据大量迁移并给集群带来高负载。
8.10.Ceph CRUSH 与设备类 Ceph CRUSH & Device Classes
CRUSH(Controlled Replication Under Scalable Hashing)是 Ceph 的基石 —— 通过映射 OSD、 bucket(设备位置)与规则集计算对象存取位置 , 无需中心索引服务。
CRUSH map 可按需修改以表达不同复制层级 , 例如按故障域隔离副本并保持期望分布。常见做法是让不同池使用不同等级的磁盘 —— 自 Luminous 起 Ceph 引入 设备类 简化此需求。设备类会在 ceph osd tree 中显示;各自形成独立 root bucket:
ceph osd crush tree --show-shadow
示例输出:
ID    CLASS  WEIGHT   TYPE NAME
-16   nvme   2.18307  root default~nvme
-13   nvme   0.72769      host sumi1~nvme
 12   nvme   0.72769          osd.12
-14   nvme   0.72769      host sumi2~nvme
 13   nvme   0.72769          osd.13
-15   nvme   0.72769      host sumi3~nvme
 14   nvme   0.72769          osd.14
 -1          7.70544  root default
 -3          2.56848      host sumi1
 12   nvme   0.72769          osd.12
 -5          2.56848      host sumi2
 13   nvme   0.72769          osd.13
 -7          2.56848      host sumi3
 14   nvme   0.72769          osd.14
要让池只在特定设备类上分布对象 , 先为设备类创建规则集:
ceph osd crush rule create-replicated <rule-name> <root> <failure-domain> <class>
| 参数 | 含义 |
|---|---|
<rule-name> | 规则名 , 供 GUI / CLI 中的池引用 |
<root> | 归属哪个 CRUSH root(默认 default) |
<failure-domain> | 对象分布所依据的故障域(通常为 host) |
<class> | OSD 后端存储类型(例如 nvme、 ssd、 hdd) |
规则进入 CRUSH map 后 , 把池指向它:
ceph osd pool set <pool-name> crush_rule <rule-name>
若池已含对象 , 它们会被相应迁移;规模取决于您的部署 , 可能对集群造成较大性能影响。备选方案 :新建池并单独迁移磁盘。
8.11.Ceph 客户端 Ceph Client
完成前述步骤后 , 可配置 Proxmox VE 使用这些池保存 VM / 容器镜像 —— 在 GUI 添加一个新的 RBD 存储(参见 §7.14)。 对于外部 Ceph 集群 , 还需把 keyring 拷贝到预定义位置;若 Ceph 安装在 Proxmox 节点本地则自动完成。
文件名必须为 <STORAGE_ID>.keyring , 其中 <STORAGE_ID> 是 /etc/pve/storage.cfg 中 rbd: 后的那段。下例 my-ceph-storage 即为 <STORAGE_ID>:
mkdir /etc/pve/priv/ceph
cp /etc/ceph/ceph.client.admin.keyring /etc/pve/priv/ceph/my-ceph-storage.keyring
8.12.CephFS CephFS
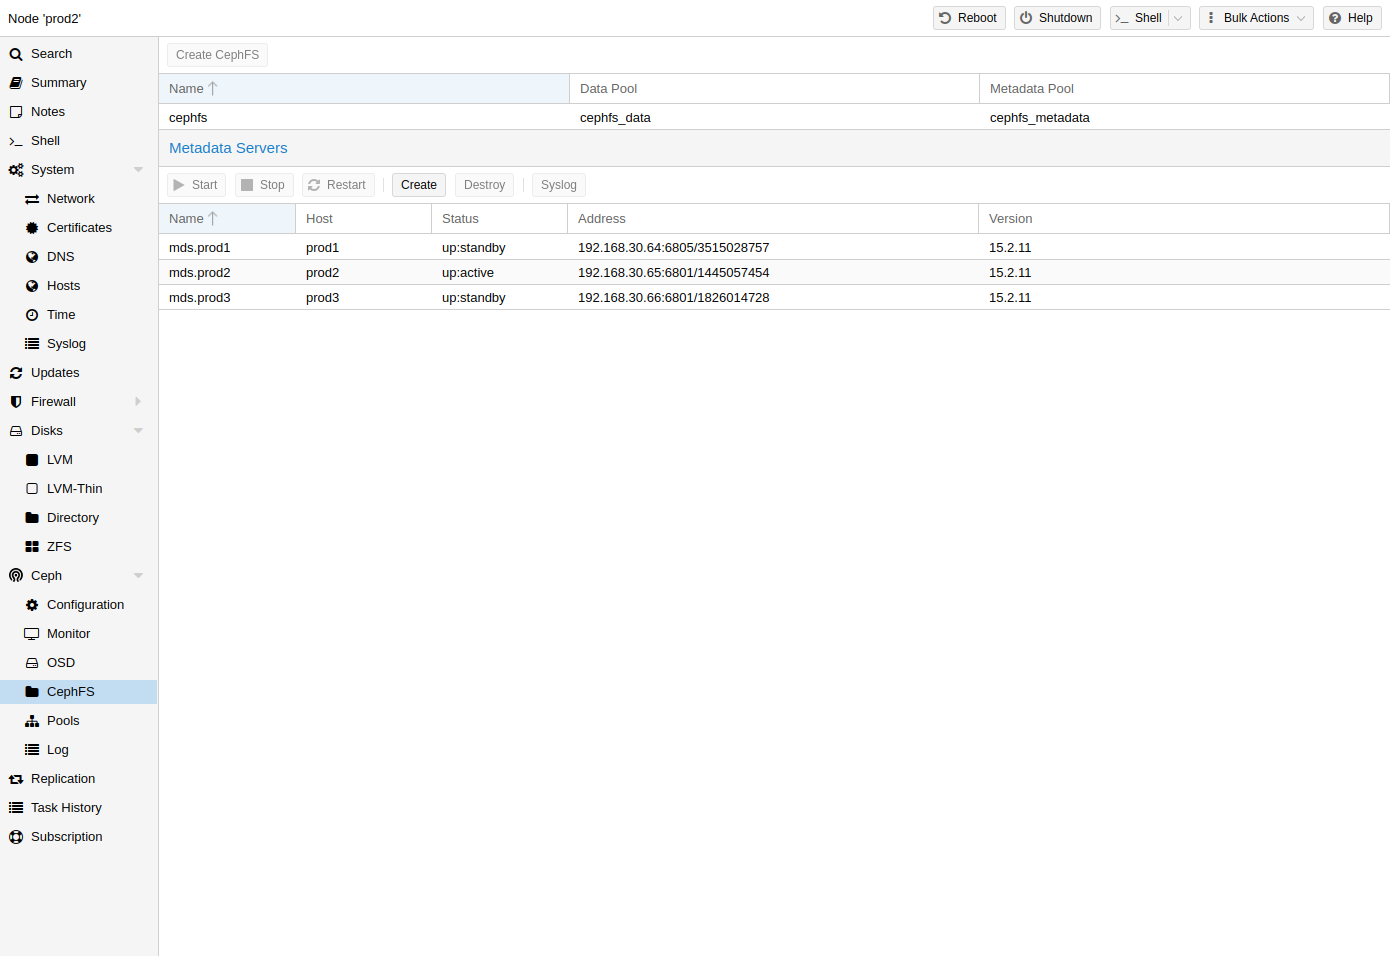
Ceph 还提供一个与 RBD 共用底层对象存储的文件系统。 元数据服务器(MDS) 负责将 RADOS 对象映射为文件与目录 , 使 Ceph 提供 POSIX 兼容的复制文件系统 , 便于搭建集群化、高可用的共享文件系统。 MDS 保证文件在整个 Ceph 集群上均匀分布 , 即便高负载也不会压垮单个主机(而 NFS 等传统方案易出此问题)。
Proxmox VE 既支持创建超融合 CephFS, 也支持把已有 CephFS 作为存储来保存备份、 ISO、容器模板。
8.12.1.元数据服务器(MDS) Metadata Server (MDS)
CephFS 必须至少配置并运行一个 MDS。通过 Web GUI Node → CephFS 或 CLI 创建:
pveceph mds create
可创建多个 MDS, 但默认同时只有一个 active。当 active 的 MDS 或其节点失联 / 崩溃 , 另一个 standby MDS 将被提升为 active。若要更快切换 , 可在创建时带 hotstandby , 或事后在 /etc/pve/ceph.conf 对应 MDS 段加:
mds standby replay = true
启用后该 MDS 保持「热」状态轮询 active , 出故障时可更快接管。
这类主动轮询会对系统与 active MDS 带来额外性能开销。
多 Active MDS
自 Luminous(12.2.x)起可同时运行多个 active MDS , 通常只有大量并行客户端时才有意义 —— 否则 MDS 很少是瓶颈。若要启用 , 参阅 Ceph 文档。
8.12.2.创建 CephFS Create CephFS
前置条件 :已安装 Ceph 包、搭好 Monitor、搭好 OSD、至少一个 MDS。
随后可通过 Web UI Node → CephFS 或 CLI 创建:
pveceph fs create --pg_num 128 --add-storage
此命令创建名为 cephfs 的 CephFS, 数据池 cephfs_data(128 PG)、元数据池 cephfs_metadata(PG 数为数据池 1/4, 即 32)。 --add-storage 会在创建成功后把 CephFS 自动加入 Proxmox VE 存储配置。
8.12.3.销毁 CephFS Destroy CephFS
销毁 CephFS 会让其上所有数据不可用 , 不可撤销!
完整、优雅地移除 CephFS 的步骤:
- 断开所有非 Proxmox VE 客户端(例如在客户机中卸载 CephFS)。
- 禁用相关 CephFS 存储条目 , 防止被自动挂载。
- 从客户机移除使用 CephFS 的资源(如 ISO)。
- 在所有节点手动卸载:
umount /mnt/pve/<STORAGE-NAME>
- 停止或销毁该 CephFS 的所有 MDS:
pveceph stop --service mds.<NAME>
pveceph mds destroy <NAME>
注意 :active MDS 被停后 standby 会自动接替 , 建议先停所有 standby。
- 销毁 CephFS 并连带删除底层池与存储:
pveceph fs destroy <NAME> --remove-storages --remove-pools
以上步骤完成后 CephFS 即被彻底移除;若仍有其他 CephFS , 可把停掉的 MDS 作为 standby 重新启动。
8.13.Ceph 维护 Ceph Maintenance
8.13.1.替换 OSD Replace OSDs
最常见的维护任务之一。若 OSD 异常但磁盘看起来仍健康 , 请先按 §8.14.1 排查。
- 若磁盘已故障 , 准备同类型同容量的推荐替换盘。
- 销毁相应 OSD。
- 从服务器上拔掉旧盘 , 插入新盘。
- 再次创建 OSD。
- 自动重平衡完成后集群应恢复
HEALTH_OK。如仍列有 crash , 可确认归档:ceph crash archive-all
8.13.2.Trim / Discard Trim/Discard
建议定期对 VM / 容器执行 fstrim(discard), 把不再使用的数据块释放回去 , 降低占用与负载。多数现代操作系统会自动下发 discard, 您只需在 VM 启用 「disk discard」选项。
8.13.3.Scrub 与 Deep Scrub Scrub & Deep Scrub
Ceph 通过 scrub PG 保证数据完整 :每天轻量元数据校验 , 每周深度数据校验(读取对象并用校验和检查)。若 scrub 影响业务性能 , 可调整执行时间。
8.13.4.关闭 Proxmox VE + Ceph HCI 集群 Shutdown Proxmox VE + Ceph HCI Cluster
先停掉所有 Ceph 客户端 —— 主要是 VM / 容器;若还有访问 CephFS 或 RADOS GW 的客户端也一并停掉。通过 Proxmox VE 工具关机的 HA 客户机会切换至 stopped。
确认集群健康:
ceph -s
为避免关机与开机阶段触发恢复 , 开启 noout:
ceph osd set noout
先关不带 Monitor 的节点 , 再关带 Monitor 的节点。上电时顺序相反 —— 先启带 Monitor 的节点 , 全部启动后确认 Ceph 服务正常。最后 , 唯一的告警应仅是 noout 仍启用 , 清除即可:
ceph osd unset noout
随后可启动客户机 ; HA 客户机通电后状态自动回到 started。
8.14.Ceph 监控与故障排除 Ceph Monitoring and Troubleshooting
从部署开始就应持续监控 Ceph 健康 —— 借助 Ceph 工具或通过 Proxmox VE API 获取状态。下列命令可查看 HEALTH_OK / HEALTH_WARN / HEALTH_ERR, 不健康时还会给出事件概览与建议动作(Ctrl+C 退出):
watch ceph --status
ceph --watch
8.14.1.故障排除 Troubleshooting
受影响节点上的相关日志
- 磁盘健康监控
- System → System Log 或 CLI(例如最近两天):
journalctl --since "2 days ago"
- IPMI 与 RAID 控制器日志
查看 Ceph 服务崩溃:
ceph crash ls
ceph crash info <crash_id>
确认归档 new 状态的 crash:
ceph crash archive-all
每个 Ceph 服务在 /var/log/ceph/ 下有日志文件;需更详细可调整日志级别。
Ceph 常见问题原因
- 网络问题 :拥塞、故障交换机、接口被关闭、防火墙阻塞 —— 检查所有 Proxmox VE 节点在 corosync 网络与 Ceph 公共 / 集群网络上的可达性。
- 磁盘或连接部件 :损坏 / 未插稳 / 高负载下 IO 性能不足(HDD、消费级硬件或不建议的 RAID 控制器)。
- 未达到 §8.3 中健康 Ceph 集群的建议。
常见 Ceph 问题
- OSD down / crashed
- 故障 OSD 会显示
down, 多数情况下约 10 分钟后自动out。具体情况也可能自动重新up+in。手动激活可在 Web UI 任一节点 → Ceph → OSD 选中该 OSD 点 Start、 In、 Reload。 Shell 下在目标节点执行:ceph-volume lvm activate --all
要激活失败的 OSD 可能需要安全重启节点 , 实在不行只能重建 / 更换 OSD。